MInTRL은 온정책 강화학습의 실행 구조를 유지하면서 필요한 지점에만 오프정책 개입을 넣고, 교정 직후 제어를 기존 정책에 돌려주는 기법이에요.
그렇다면 기존 정책을 계속 학습시키면서 외부 개입의 이점을 함께 얻을 수 있을까요?
저자들은 중요도 샘플링 없이 학습한 MInTRL이 수학과 코드 벤치마크에서 기준선보다 우수했다고 보고했어요.
다만 이는 사전공개 논문의 저자 보고이며, Hugging Face의 순위와 추천 수는 성능 검증 결과가 아니라 페이지 반응 지표로 구분해야 해요.
희소한 국소 교정 뒤 기존 정책에 즉시 제어를 반환
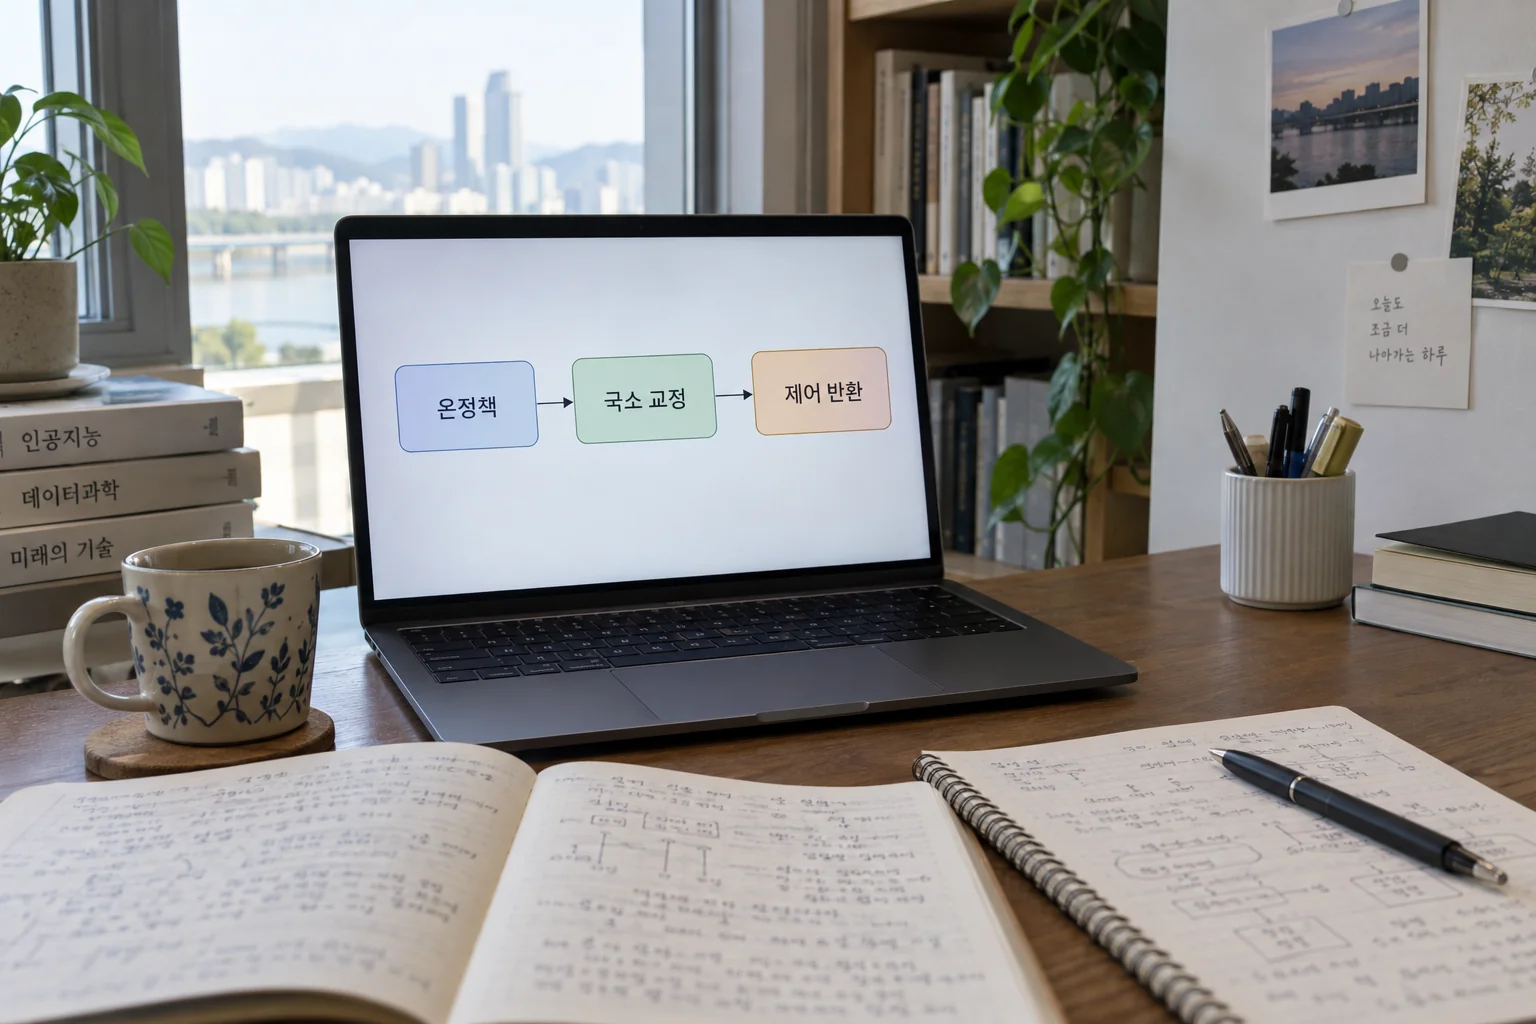
MInTRL의 핵심은 오프정책 개입이 계속 행동을 지배하지 않고, 희소한 국소 교정이 끝나면 온정책에 즉시 제어권을 돌려준다는 점이에요.
제공된 자료가 설명하는 구조는 지속적인 대체가 아니라 제한된 개입과 빠른 복귀의 결합이에요.
오프정책 개입이 온정책 학습을 보조하되, 학습의 중심은 기존 정책에 남는 셈이지요.
따라서 제목의 “Off-policy Intervention can boost On-policy RL”은 온정책 강화학습을 폐기한다는 뜻이 아니라, 특정 지점의 개입으로 그 학습을 강화할 수 있다는 저자들의 문제의식으로 읽어야 해요.
핵심은 개입의 범위입니다.
기업의 모델 운영 관점에서는 누가 개입했는지보다 개입이 어디까지 이어지고 언제 기존 정책으로 돌아가는지가 중요한 통제 항목이 돼요.
MInTRL은 교정 직후 정책에 제어를 반환한다고 설명되므로, 개입 자체와 복귀 이후의 정책 행동을 분리해 살펴볼 필요가 있어요.
그렇다고 논문 자료만으로 실제 기업 환경의 책임 배분이나 통제 절차가 검증됐다고 볼 수 있을까요?
제공된 근거는 수학과 코드 벤치마크의 연구 결과에 한정되며, 기업 업무나 사고 대응에 관한 별도 사례는 제시되지 않았어요.
적용 범위를 넓혀 해석하지 않는 것이 중요하겠네요.
중요도 샘플링 없이 결합한 온정책 학습과 오프정책 개입
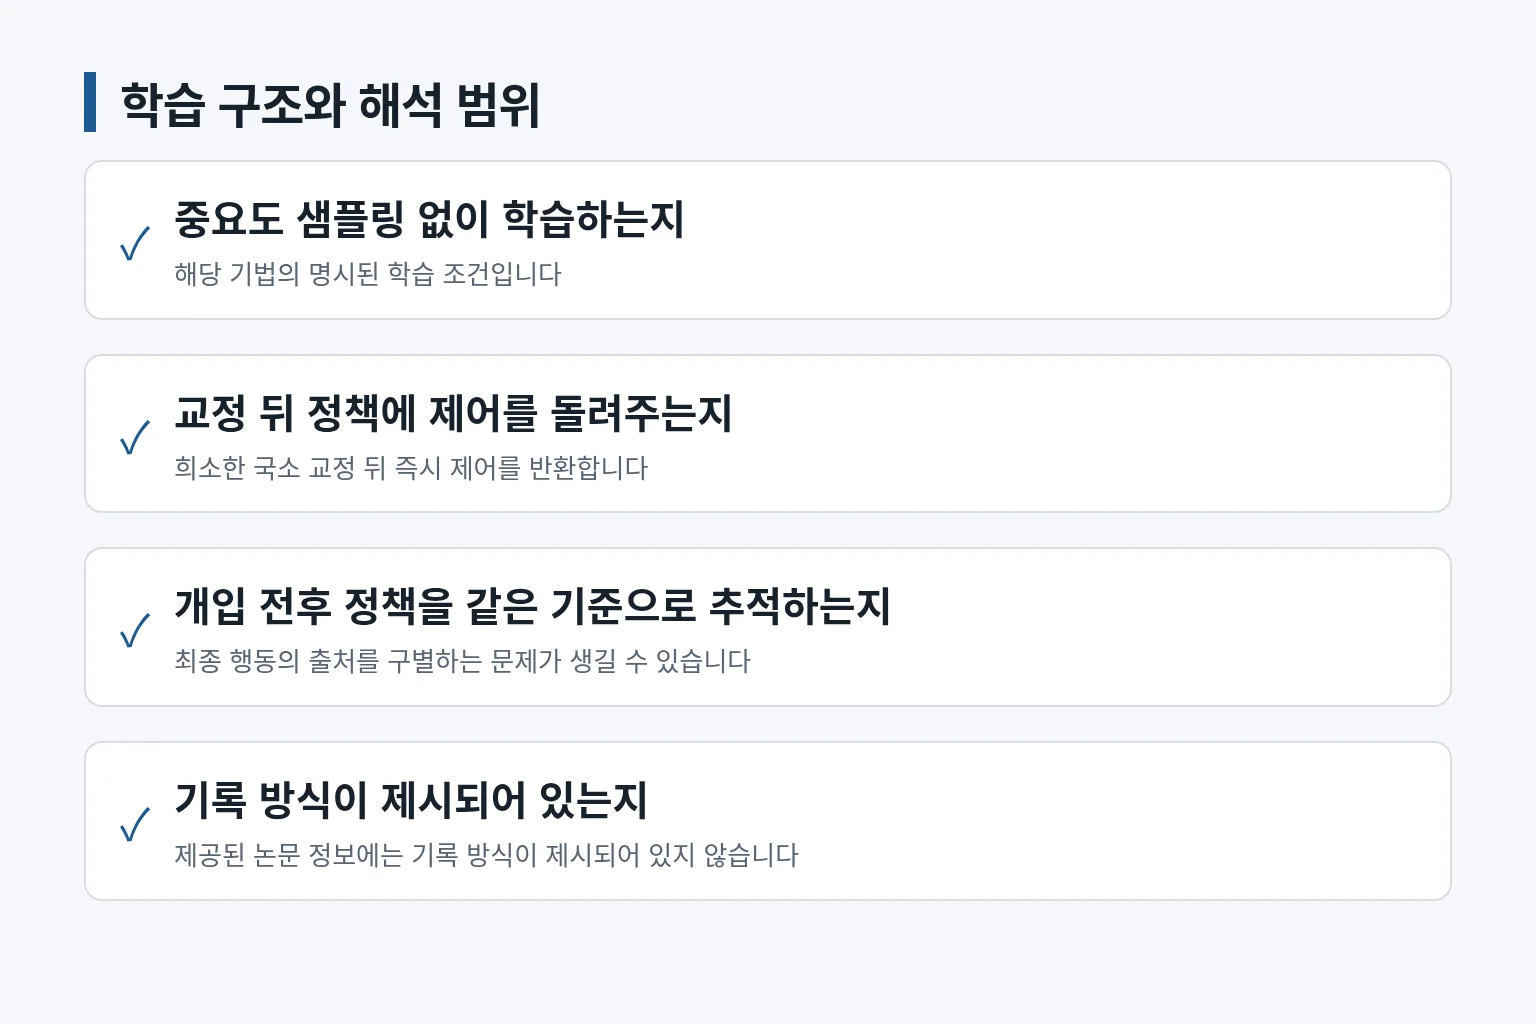
MInTRL은 중요도 샘플링을 사용하지 않으면서 오프정책 개입과 온정책 학습을 결합한 기법이에요.
이 특징은 제공된 사전조사에서 명시된 학습 조건이며, 다른 보정 방식이나 계산 절차까지 포함한다는 의미는 아니에요.
중요도 샘플링이 없다는 사실만으로 학습 안정성이나 운영 비용이 자동으로 개선된다고 단정해서도 안 돼요.
자료가 확인해 주는 범위는 해당 기법이 중요도 샘플링 없이 학습한다는 데까지예요.
구조와 효과의 구분.
희소한 국소 교정 뒤 정책에 즉시 제어를 돌려주는 온정책 RL 기법이며, 중요도 샘플링 없이 학습한다.
arXiv에 등록된 MInTRL 사전공개 논문(arxiv.org/abs/2609.12419)
기업이 이 연구를 해석할 때는 개입 여부만 보는 대신, 개입 전 정책과 개입 후 정책을 같은 기준으로 추적할 수 있는지를 살펴야 해요.
교정이 국소적으로 이뤄지고 제어가 즉시 반환된다면, 최종 행동이 개입에서 직접 나왔는지 복귀한 정책에서 나왔는지를 구별하는 문제가 생길 수 있지요.
다만 제공된 논문 정보에는 기록 방식, 감사 절차, 책임 주체 또는 보험 보장조건이 제시되어 있지 않아요.
따라서 이 연구만으로 사고 책임이나 보장 여부를 판단할 수는 없으며, 확인 가능한 내용은 학습 구조와 저자들이 보고한 벤치마크 결과예요.
기술적 성능 주장과 기업의 책임 구조는 별도의 판단 대상이에요.
수학과 코드 벤치마크의 우수성은 저자 보고 단계
저자들은 MInTRL이 수학과 코드 벤치마크에서 기준선보다 우수했다고 보고했어요.
이는 MInTRL의 효과를 뒷받침하는 핵심 결과이지만, 사전공개 논문에 담긴 저자들의 보고라는 조건이 함께 붙어요.
어떤 기준선과 세부 설정을 사용했는지, 개선 폭이 어느 정도인지에 관한 수치는 제공된 자료에 없어요.
그러므로 우수하다는 표현을 기업의 모든 과제와 운영 환경에 일반화할 수 있을까요?
현재 근거만으로는 어려워요.
수학·코드 벤치마크에서 기준선보다 우수하다고 저자들이 보고했다.
Hugging Face에 게시된 MInTRL 논문 카드(huggingface.co/papers/2609.12419)
수학과 코드 벤치마크는 이 논문의 성능 주장이 제시된 평가 범위이며, 기업의 실제 업무 처리나 사고 발생 가능성을 직접 측정한 자료는 아니에요.
따라서 벤치마크 우수성은 해당 평가 조건에서의 연구 결과로 다뤄야 하며, 책임 감소나 손실 방지 효과로 바꾸어 표현해서는 안 돼요.
특히 개입이 희소하고 국소적이라는 구조가 실제 운영에서도 같은 효과를 내는지는 제공된 사실만으로 확인되지 않아요.
연구 결과와 운영 성과 사이의 간격.
기업 리스크 관점에서는 이 간격 자체가 검토 대상이 돼요.
2026년 9월 11일 공개 기록과 변동하는 반응 지표
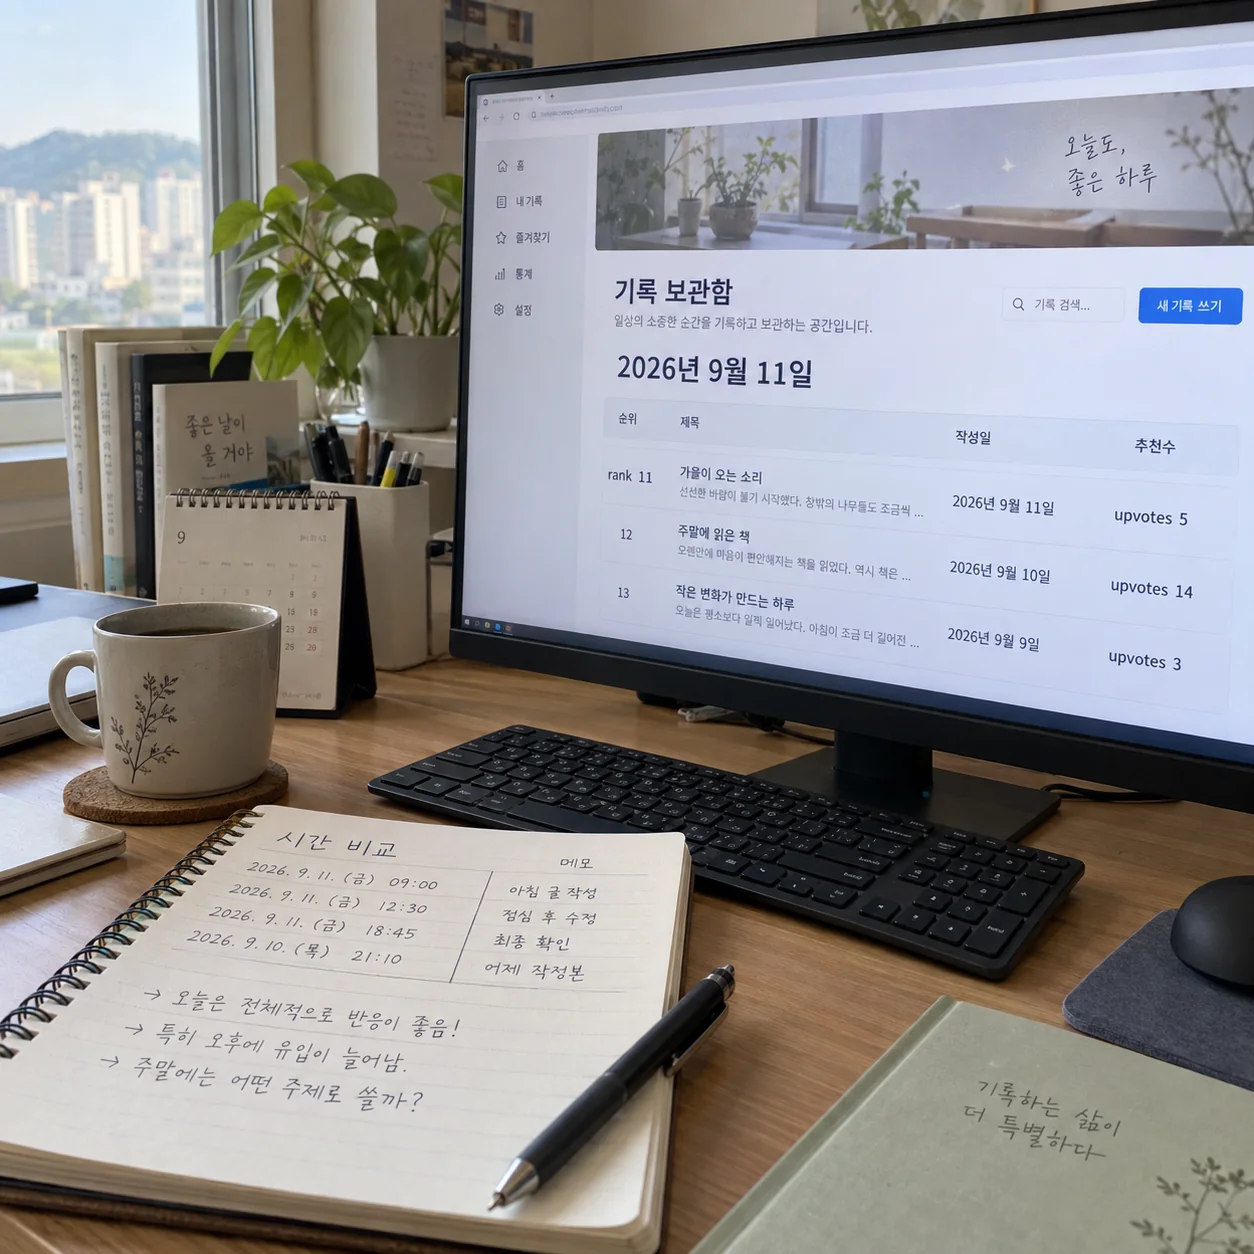
MInTRL v1은 arXiv에 2026년 9월 11일 제출됐고, Hugging Face Daily Papers에도 같은 날짜에 게시됐어요.
주어진 최초 기록에는 해당 항목이 rank 11, upvotes 5로 표시됐지만, 사전조사 시점의 현재 페이지에는 upvotes 14가 표시됐으며 rank는 확인되지 않았어요.
따라서 upvotes 5와 upvotes 14는 서로 다른 확인 시점의 변동 지표로 함께 이해해야 해요.
기준일은 2026년 9월 16일 04:35이며, 이후에도 같은 값이 유지된다고 단정할 수는 없어요.
순위 역시 현재 값이 확인되지 않았으므로 rank 11을 지속적인 위치로 표현해서는 안 되지요.
이 반응 지표는 논문의 학습 성능과 별개의 정보예요.
추천 수가 변했다는 사실은 페이지 이용자의 반응이 달라졌음을 보여주지만, 벤치마크 결과를 추가로 검증하거나 기업 적용 가능성을 입증하지는 않아요.
마찬가지로 과거 rank 11은 게시 당시 제공된 위치 정보일 뿐, 연구 품질이나 책임 관리 수준을 나타내는 척도가 아니에요.
기업이 자료를 인용할 때는 논문 제출 사실, 저자의 성능 보고, 페이지 반응 지표를 구분해야 혼선을 줄일 수 있어요.
유효기간은 확인되지 않았으므로 특정 시점까지 결과가 유효하다는 표현도 피해야 해요.
함께 읽기